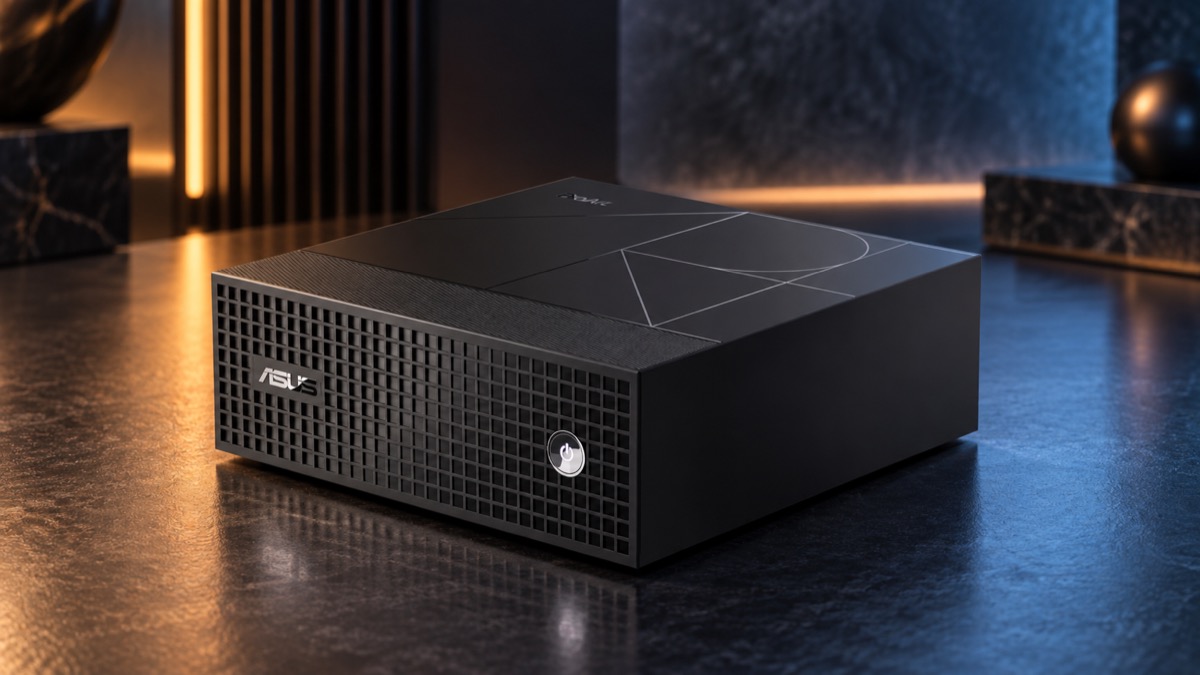
L’ASUS ProArt GR1X n’est pas un mini-PC de plus. C’est une petite station de travail Windows conçue pour faire tourner des modèles d’IA et des agents directement dans l’entreprise, sans envoyer chaque document, requête ou fichier vers un service cloud. Présenté par ASUS le 2 septembre 2026 à l’IFA, il repose sur la nouvelle plateforme NVIDIA RTX Spark N1X, avec GPU Blackwell, CPU Grace, jusqu’à 128 Go de mémoire unifiée et jusqu’à 1 pétaflop de calcul IA en FP4.
Dit comme cela, le produit semble réservé aux développeurs. Pourtant son intérêt est beaucoup plus large : cabinet d’architectes, petite agence, bureau d’études, cabinet médical, PME ou indépendant peuvent imaginer un serveur IA privé de bureau capable de résumer des dossiers, rechercher dans une base documentaire, classer des pièces, produire des brouillons, assister le code ou faire tourner des agents pendant des heures sans compteur de tokens. La vraie question n’est donc pas « est-il puissant ? », mais dans quels cas acheter sa propre capacité d’IA peut-il avoir du sens économiquement ?
TL;DR
✅ Jusqu’à 128 Go de mémoire unifiée et 1 PFLOP FP4 : assez pour exécuter localement de gros modèles et plusieurs agents.
✅ Windows + CUDA : plus simple à intégrer dans un environnement de TPE/PME qu’une appliance Linux pure.
✅ Très pertinent pour les traitements répétitifs, les données sensibles et les agents qui tournent en permanence.
⚠️ À plus de 4 000 € HT dans les premières références françaises, il ne remplace pas économiquement deux abonnements ChatGPT à lui seul.
⚠️ L’IA locale complète le cloud ; elle ne remplace pas systématiquement les meilleurs modèles OpenAI, Anthropic ou Google.
📡 ÉTAT DU DOSSIER — MIS À JOUR LE 22/09/2026
Statut : annoncé, pré-référencé en France
- ✅ Confirmé : ASUS a officialisé le ProArt GR1X le 2 septembre 2026 à l’IFA. La fiche technique ASUS confirme Windows 11, RTX Spark N1X, GPU Blackwell 6 144 cœurs, CPU Grace 20 cœurs, jusqu’à 128 Go de mémoire unifiée, 10 GbE et Wi‑Fi 7. Source ASUS, 02/09/2026.
- ✅ Signal France : PC21 référence déjà une configuration à 4 398,90 € HT / 5 278,68 € TTC, sur commande et sans stock au relevé du 22 septembre. Source PC21.
- ❓ Non confirmé : prix public ASUS France, date de disponibilité grand public et éventuelle fiche Amazon.fr.
- 🔎 Je n’ai pas encore eu l’appareil en main. Ce dossier sera mis à jour à chaque étape.
Le ProArt GR1X, c’est quoi exactement ?
Le plus simple est d’oublier un instant les termes « supercalculateur personnel » ou « agentic AI PC ». Le GR1X est un ordinateur compact spécialisé dans l’inférence IA : on lui donne un modèle déjà entraîné, des documents et des outils, puis il exécute les requêtes localement.
ASUS utilise le NVIDIA RTX Spark N1X : un GPU Blackwell de 6 144 cœurs associé à un CPU Grace 20 cœurs et à de la mémoire LPDDR5X unifiée. Cette architecture peut disposer de 128 Go dans un même pool mémoire. C’est essentiel : un gros modèle ne tient pas seulement grâce à la puissance du GPU, il faut surtout pouvoir charger ses poids et son contexte en mémoire.
ASUS annonce la prise en charge de modèles jusqu’à 120 milliards de paramètres, jusqu’à 1 million de tokens de contexte selon les usages présentés par la marque, ainsi que des workflows de génération vidéo 4K et de rendu 3D dépassant 90 Go. La machine mesure seulement 150 × 150 × 51 mm, avec un TDP annoncé de 140 W et une alimentation de 240 W. Fiche produit ASUS.
Pourquoi 128 Go de mémoire changent beaucoup de choses
Sur un PC classique équipé d’une carte graphique de 16 ou 24 Go de VRAM, tu peux déjà faire tourner d’excellents modèles locaux. Mais plus le modèle grossit, plus il faut réduire sa précision, raccourcir le contexte ou déporter une partie du calcul vers la RAM système, avec une chute de performances.
Avec 128 Go de mémoire unifiée, le GR1X vise précisément ce verrou. Un modèle de 30 à 40 milliards de paramètres peut être servi confortablement avec beaucoup de contexte ; des modèles plus gros restent envisageables avec quantification. Cette réserve permet aussi de faire tourner plusieurs composants simultanément : modèle principal, modèle d’embeddings, reranker, vision, base vectorielle et agents spécialisés.
C’est ce qui rapproche le GR1X du NVIDIA DGX Spark que nous avons déjà présenté sur SysKB. Le DGX Spark dispose lui aussi de 128 Go de mémoire unifiée, mais fonctionne avec l’écosystème DGX OS/Linux. Le GR1X prend une autre direction : la même philosophie de calcul IA compact, mais dans un PC Windows utilisable comme poste de travail.
Concrètement, comment transforme-t-on cette machine en « IA d’entreprise » ?
Le scénario le plus simple consiste à installer un moteur d’inférence local, puis une interface web et enfin une couche documentaire. Des outils comme Ollama, llama.cpp, vLLM, LM Studio ou Open WebUI permettent déjà de construire ce type d’environnement sur les plateformes NVIDIA compatibles. NVIDIA publie d’ailleurs des playbooks officiels DGX Spark pour Open WebUI, LM Studio, le RAG et des systèmes multi-agents ; la logique logicielle est directement transposable aux machines RTX Spark lorsque les versions Windows des composants sont disponibles.
Un déploiement réaliste pour une petite entreprise peut ressembler à ceci :
- Choisir un modèle local adapté au travail : Qwen, Gemma, Llama, gpt-oss ou un autre modèle ouvert.
- Exposer le modèle sur le réseau local via une API compatible OpenAI ou une interface comme Open WebUI.
- Indexer les documents internes dans une base RAG : PDF, procédures, contrats, documentation technique, archives.
- Créer des agents spécialisés : recherche documentaire, rédaction, classement, extraction de données, assistance au code.
- Connecter les outils autorisés : dossier réseau, CRM, GED, messagerie ou bases métier, avec des droits strictement limités.
- Conserver un accès cloud pour les tâches qui nécessitent ponctuellement un modèle frontier plus performant.
Cette approche rejoint directement le mouvement décrit dans notre dossier sur Project Zenith et les PC Windows taillés pour l’IA locale : le PC n’est plus seulement le terminal qui appelle une IA distante ; il devient lui-même un serveur d’inférence.
Exemple 1 : un cabinet d’architectes
Imagine un cabinet de cinq personnes qui accumule des milliers de PDF, notices techniques, CCTP, comptes rendus, mails, plans exportés et documents réglementaires. Un agent local peut indexer ce corpus et répondre à des questions du type : « retrouve toutes les réserves concernant l’étanchéité sur ce projet », « compare les prescriptions de ces trois CCTP » ou « prépare une synthèse des modifications depuis la version précédente ».
L’intérêt n’est pas seulement de gagner quelques minutes. L’agent peut tourner en arrière-plan, surveiller un dossier, indexer de nouveaux fichiers et préparer des synthèses pendant que les collaborateurs travaillent. Une machine locale évite aussi d’envoyer systématiquement les documents de clients vers un service externe. Cela ne dispense évidemment pas d’une politique de sécurité, de sauvegarde et de droits d’accès.
Exemple 2 : une petite société de services
Une TPE peut utiliser le GR1X comme « employé numérique » pour des tâches à faible valeur unitaire mais très répétitives : classifier les demandes entrantes, extraire les informations d’un devis, préparer une réponse, générer un compte rendu, produire une fiche CRM, comparer deux contrats ou surveiller une base documentaire.
Le point intéressant est la marginalité du coût. Une fois le matériel acheté, faire tourner mille requêtes supplémentaires ne déclenche pas mille appels facturés à une API. Cela ne veut pas dire que le calcul est gratuit — il faut compter électricité, administration, sauvegarde et maintenance — mais le coût devient plus prévisible.
Exemple 3 : développement et automatisation 24/7
Pour un développeur indépendant ou une petite équipe, le cas d’usage est particulièrement naturel : revue de code, documentation, génération de tests, analyse de logs, tri d’issues ou agent CLI. NVIDIA propose déjà un playbook où Ollama sert un modèle Qwen local connecté à Claude Code, OpenCode ou Codex CLI sur DGX Spark. Le principe est intéressant : l’outil agentique reste le même, mais le modèle d’inférence peut être local.
Tu peux donc réserver les modèles cloud coûteux aux tâches difficiles et laisser un modèle local traiter le travail routinier : reformater du code, créer des tests, rechercher dans une documentation interne ou produire une première passe.
Et pour un cabinet médical ? Oui, mais avec de grosses précautions
Un environnement de santé peut trouver un intérêt évident à l’IA locale pour rechercher dans des procédures internes, préparer des courriers non cliniques, classer des documents administratifs ou exploiter une base documentaire. Mais « local » ne signifie pas automatiquement « conforme ». Les données de santé sont particulièrement sensibles : chiffrement, sauvegardes, journalisation, contrôle d’accès, segmentation réseau et cadre réglementaire restent indispensables.
Pour des usages médicaux ou décisionnels, un modèle local ne doit pas être présenté comme un substitut autonome au professionnel. Le cas d’usage pertinent est d’abord l’assistance documentaire et administrative, avec validation humaine.
Peut-on vraiment économiser de l’argent face à ChatGPT ou Claude ?
Il faut être précis. Un GR1X à environ 4 399 € HT dans la première référence française repérée représente environ 122 € HT par mois sur trois ans avant électricité et maintenance. Deux licences ChatGPT Business standard coûtent actuellement 40 $ par mois en facturation annuelle. Acheter un GR1X uniquement pour remplacer deux abonnements SaaS n’a donc aucun sens économique.
En revanche, le calcul change quand l’entreprise utilise beaucoup d’API, plusieurs agents ou des traitements en continu. Les tarifs API se comptent par millions de tokens ; un workflow qui relit chaque nuit des centaines de documents, génère des embeddings, effectue plusieurs passes de raisonnement et recommence tous les jours peut produire une facture variable. Le local transforme une partie de cette dépense en capacité fixe que l’on possède.
Le meilleur modèle économique est donc souvent hybride : modèles ouverts locaux pour 70 à 90 % des tâches répétitives et privées, puis OpenAI, Claude ou Gemini pour les 10 à 30 % de cas où l’on veut une intelligence frontier, une recherche web avancée ou un contexte cloud spécifique. Notre comparatif Claude vs ChatGPT vs Gemini permet justement de voir ce que les services cloud apportent encore.
GR1X vs NVIDIA DGX Spark vs Mac Studio : trois philosophies
| Machine | Positionnement | Mémoire | Atout principal | Limite |
|---|---|---|---|---|
| ASUS ProArt GR1X | PC Windows IA / création | 64 ou 128 Go unifiés | Windows + CUDA + usage poste de travail | Prix élevé, disponibilité encore limitée |
| NVIDIA DGX Spark | Appliance IA personnelle | 128 Go unifiés | Écosystème NVIDIA IA très intégré | Plus orienté développeurs/Linux |
| Mac Studio M4 Max | Workstation créative | jusqu’à 128 Go unifiés | Silence, efficacité, excellent écosystème créatif | Pas de CUDA ; certains frameworks IA sont optimisés d’abord pour NVIDIA |
| Mac mini M4 Pro | Entrée de gamme IA locale | jusqu’à 64 Go | Prix et compacité | Moins adapté aux très gros modèles |
Le DGX Spark est le plus proche techniquement : NVIDIA annonce 128 Go de mémoire unifiée et jusqu’à 1 PFLOP FP4, avec une pile logicielle explicitement construite pour les agents locaux. Le Mac Studio est une alternative crédible lorsque l’on privilégie macOS, la création et les modèles compatibles Metal/MLX. Le Mac mini M4 Pro est beaucoup moins cher et suffit déjà pour découvrir sérieusement l’IA locale, mais ses configurations mémoire plafonnent plus bas.
Comparer les machines disponibles
Voir les Mac mini M4 Pro sur Amazon.fr Voir les Mac Studio M4 Max sur Amazon.fr Chercher le NVIDIA DGX Spark sur Amazon.fr Surveiller le ProArt GR1X sur Amazon.frTransparence : ces liens sont affiliés. Si tu achètes via l’un d’eux, SysKB peut recevoir une commission, sans coût supplémentaire pour toi. Les liens utilisent la recherche Amazon lorsque l’ASIN exact n’a pas été vérifié ; vérifie toujours la configuration mémoire et le vendeur avant achat.
À qui le ProArt GR1X peut réellement faire gagner de l’argent ?
Le GR1X devient intéressant lorsque trois conditions se cumulent : beaucoup de traitements, des données que l’on préfère garder en interne, et des workflows suffisamment répétitifs pour être automatisés. Dans ce cas, la machine n’est plus un PC : c’est une petite infrastructure.
- Agence / cabinet : recherche permanente dans les dossiers clients, synthèses, extraction et classement.
- Bureau d’études : interrogation de documentation technique, procédures et normes internes.
- Studio créatif : génération locale d’images, vidéo et assistance aux workflows 3D.
- Développeur / ESN : agents de code, documentation, tests et analyse de logs.
- E-commerce : enrichissement catalogue, classement de tickets, réponses préparatoires et contrôle qualité.
- PME industrielle : assistant local sur documentation maintenance, procédures, pièces et historiques d’intervention.
- Profession libérale : classement documentaire, recherche sémantique et rédaction de premiers jets.
Dans tous ces cas, le gain ne vient pas d’une conversation occasionnelle avec un chatbot. Il vient de l’automatisation répétée. Un agent qui économise seulement 30 minutes par jour à cinq personnes représente déjà plusieurs dizaines d’heures par mois. C’est sur ce terrain qu’une machine à plusieurs milliers d’euros peut devenir un investissement productif.
Les limites à ne surtout pas ignorer
La première limite est la qualité des modèles. Un modèle open source de 30, 70 ou 120 milliards de paramètres peut être excellent, mais il ne sera pas systématiquement au niveau d’un modèle frontier récent sur le raisonnement complexe, la recherche web ou certains domaines spécialisés.
La seconde est l’exploitation. Une IA locale implique mises à jour, sécurité, sauvegardes, contrôle d’accès, monitoring et choix des modèles. Si personne ne sait administrer le système, la promesse de coûts maîtrisés peut vite se transformer en temps perdu.
Enfin, un agent autonome est un logiciel auquel on donne des droits. Plus on lui permet d’accéder à des fichiers, mails, navigateurs ou outils métier, plus il faut isoler ses permissions. NVIDIA pousse d’ailleurs des approches de sandboxing pour ses agents locaux. La règle est simple : un modèle local protège mieux les données du cloud, mais il ne supprime pas les risques de sécurité.
Le GR1X est peut-être le PC le plus intéressant de cette nouvelle génération
Le ProArt GR1X est cher, mais son intérêt n’est pas de battre un PC gamer sur un benchmark. Il vise une nouvelle catégorie : le serveur IA personnel qui reste suffisamment simple pour devenir un PC de bureau. Windows, CUDA, 128 Go de mémoire unifiée, 10 GbE et un format de 1,1 litre forment une combinaison inhabituelle.
Pour une petite structure, je ne conseillerais pas de l’acheter simplement pour « avoir de l’IA locale ». Un Mac mini, un PC RTX existant ou même une machine plus modeste suffit pour apprendre. En revanche, si l’on identifie déjà plusieurs agents qui peuvent tourner tous les jours, exploiter une base documentaire privée ou absorber une consommation d’API importante, le GR1X commence à ressembler non plus à une dépense informatique, mais à un outil de production.
Ce dossier sera mis à jour dès qu’ASUS précisera le prix public France, la date de disponibilité et les configurations réellement commercialisées. Il rejoindra également notre guide Windows, IT & Sécurité, où nous suivons les matériels et plateformes qui changent concrètement la manière de travailler.
Journal de ce dossier
- 22/09/2026 — création du dossier : annonce ASUS IFA, caractéristiques RTX Spark N1X, pré-référencement France et analyse des usages IA locale pour TPE/PME.