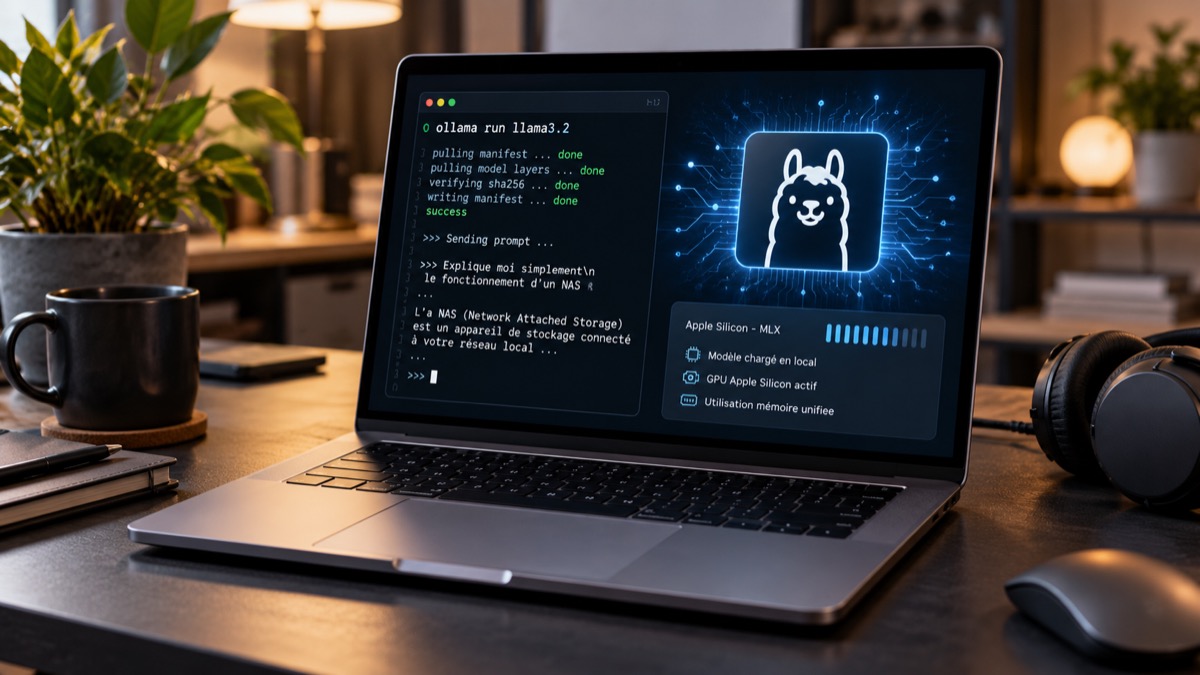
Faire tourner une IA générative directement sur son Mac n’est plus réservé aux développeurs. Ollama permet aujourd’hui de télécharger un modèle, de l’exécuter localement et de discuter avec lui sans envoyer systématiquement ses données vers un service cloud. Sur les Mac Apple Silicon, le logiciel s’appuie désormais sur MLX pour exploiter efficacement la mémoire unifiée et le GPU.
⚡ TL;DR — L’ESSENTIEL EN 30 SECONDES
- ✅ Ollama permet d’exécuter des modèles d’IA directement sur un Mac, avec une interface graphique et un accès en ligne de commande.
- ✅ Sur Apple Silicon, Ollama exploite MLX et la mémoire unifiée, ce qui rend les petits et moyens modèles particulièrement intéressants en local.
- ⚠️ La mémoire du Mac reste la principale limite : un modèle trop gros peut devenir lent ou simplement ne pas tenir confortablement en mémoire.
- ⚠️ « Local » ne signifie pas automatiquement « meilleur » : les grands services cloud restent généralement plus adaptés aux tâches très complexes.
Pourquoi faire tourner une IA directement sur son Mac ?
L’intérêt principal est la maîtrise des données. Une fois le modèle téléchargé, une conversation exécutée avec un modèle local peut rester sur la machine. C’est utile pour résumer des notes personnelles, travailler sur du code ou analyser des documents que l’on ne souhaite pas transmettre à un service distant.
Le second avantage est l’usage hors connexion. Le modèle étant stocké sur le Mac, il reste utilisable sans accès Internet. Il n’y a pas non plus de facturation à la requête pour l’inférence locale : le coût est essentiellement celui de la machine et de l’électricité.
Ce fonctionnement ne remplace pas nécessairement ChatGPT, Claude ou Gemini. Il ajoute plutôt une seconde option : local lorsque confidentialité, disponibilité hors ligne ou expérimentation priment ; cloud lorsque l’on recherche les modèles les plus puissants et des services intégrés.
Ollama est devenu beaucoup plus accessible
Ollama était initialement très associé au Terminal. Ce n’est plus la seule façon de l’utiliser : l’application macOS permet désormais de télécharger des modèles et de discuter avec eux dans une interface graphique. Elle sait également recevoir des fichiers et, avec les modèles compatibles, des images.
La ligne de commande reste toutefois intéressante. Après installation, une commande du type ollama run nom-du-modele télécharge le modèle s’il n’est pas encore présent puis lance la conversation. Cette simplicité explique en partie le succès d’Ollama auprès des utilisateurs qui souhaitent expérimenter avec plusieurs modèles ouverts sans construire eux-mêmes toute la chaîne logicielle.
Apple Silicon et MLX : pourquoi le Mac est intéressant pour l’IA locale
Depuis 2026, Ollama utilise MLX sur Apple Silicon. MLX est le framework de calcul machine learning développé par Apple pour ses propres puces. L’un de ses atouts est de tirer parti de l’architecture à mémoire unifiée : CPU et GPU peuvent accéder au même ensemble de mémoire sans passer par une VRAM séparée comme sur un PC équipé d’une carte graphique classique.
Ollama a annoncé en juin 2026 de nouvelles optimisations MLX pouvant améliorer les performances et réduire l’empreinte mémoire de certains modèles. Apple met également en avant MLX pour l’inférence locale et les agents sur Mac. Cela ne transforme pas un MacBook Air en serveur d’IA, mais rend les machines Apple Silicon particulièrement cohérentes pour expérimenter avec des modèles raisonnablement dimensionnés.
Si vous utilisez déjà les fonctions natives d’Apple, notre guide Siri et Apple Intelligence sur MacBook permet de bien distinguer l’IA intégrée par Apple d’un moteur local indépendant comme Ollama.
8, 16, 24 ou 32 Go : combien de mémoire faut-il ?
Il n’existe pas de seuil universel, car la consommation dépend du modèle, de sa quantification et de la taille du contexte. La règle utile est simple : plus le modèle contient de paramètres et plus le contexte est long, plus la mémoire nécessaire augmente. macOS doit en outre conserver assez de mémoire pour le système et les autres applications.
Un exemple concret fourni par Ollama avec la famille d3 illustre bien cette progression : le modèle 2B est associé à des systèmes Apple Silicon de 8 Go, le 4B à 16 Go, le 9B à 32 Go et le 27B à 64 Go. Il ne faut pas généraliser ces chiffres à tous les modèles, mais ils montrent pourquoi la quantité de mémoire unifiée compte souvent davantage que quelques pourcents de puissance CPU lorsque l’objectif est l’IA locale.
Pour débuter, mieux vaut donc choisir un modèle compact adapté à la mémoire disponible plutôt que télécharger immédiatement le plus gros modèle de la bibliothèque. Un modèle plus petit qui répond rapidement est souvent plus agréable qu’un modèle théoriquement supérieur qui oblige le Mac à paginer massivement sur son SSD.
Le stockage peut vite devenir un sujet
Tester plusieurs modèles finit par consommer plusieurs dizaines de gigaoctets. Il est donc judicieux de surveiller l’espace libre avant d’accumuler les variantes. Un SSD externe rapide peut aussi être utile pour les utilisateurs qui stockent beaucoup de modèles, de jeux de données ou de documents de travail, à condition d’adapter la configuration de stockage d’Ollama à son environnement.
À titre d’exemple, le Samsung T7 Shield 1 To est proposé sur Amazon.fr sous la référence MU-PE1T0R/EU, avec une interface USB 3.2 Gen 2 et des débits constructeur annoncés jusqu’à 1 050 Mo/s en lecture et 1 000 Mo/s en écriture. Le prix affiché peut évoluer : vérifiez toujours le tarif et le vendeur au moment de l’achat.
En tant que Partenaire Amazon, SysKB réalise un bénéfice sur les achats remplissant les conditions requises, sans surcoût pour le lecteur.
Quel modèle choisir pour commencer ?
Évitez de choisir uniquement sur le nombre de paramètres. Commencez par définir l’usage : conversation générale, code, vision, classement de textes ou raisonnement. La bibliothèque Ollama indique les variantes disponibles et leur taille ; certaines familles proposent plusieurs niveaux permettant de tester progressivement ce que votre Mac supporte confortablement.
Pour une première prise en main, un petit modèle récent est suffisant pour comprendre le fonctionnement, mesurer la vitesse et vérifier la consommation mémoire. Vous pourrez ensuite monter en gamme. Cette approche est d’autant plus pertinente qu’Ollama continue d’améliorer son moteur MLX et sa prise en charge des formats quantifiés.
Une nouveauté intéressante : la synthèse vocale locale
Ollama a annoncé le 24 octobre 2026 la prise en charge de modèles de synthèse vocale, d’abord sur macOS. Le premier modèle proposé est Phonon : il transforme du texte en parole directement depuis Ollama. C’est un bon exemple de l’évolution de l’outil, qui dépasse progressivement le simple chatbot local pour devenir une plateforme d’exécution de différents types de modèles.
Cette fonction est encore récente et les performances publiées par Ollama ont notamment été mesurées sur un MacBook Pro M5 Max ; il ne faut donc pas extrapoler ces résultats à tous les Mac. Elle montre néanmoins l’intérêt croissant d’Apple Silicon pour des traitements IA qui restent sur la machine.
Les limites à connaître avant de se lancer
Une IA locale n’est pas automatiquement privée dans toutes les situations : il faut vérifier que l’on utilise bien un modèle local et non une variante cloud. Ollama propose aujourd’hui les deux modes. Un modèle local n’a par ailleurs pas accès par magie aux informations récentes du Web ; sans outil supplémentaire, ses connaissances restent celles intégrées au modèle.
Enfin, les modèles compacts peuvent halluciner, mal interpréter une consigne ou être nettement moins performants qu’un grand modèle hébergé dans le cloud. Pour un document important, du code destiné à la production ou une décision sensible, les réponses doivent rester vérifiées.
Ollama vaut-il le coup sur un Mac ?
Oui, surtout sur Apple Silicon, à condition de garder des attentes réalistes. L’installation est devenue simple, les performances MLX progressent et il est possible d’expérimenter sans abonnement avec une grande variété de modèles. Un Mac doté de 16 Go ou davantage offre naturellement plus de latitude, mais même une configuration plus modeste peut servir à découvrir des modèles compacts.
Le vrai intérêt n’est pas de remplacer systématiquement les IA cloud. C’est de disposer d’une IA complémentaire, locale, hors ligne et contrôlable, particulièrement intéressante pour les données privées et l’expérimentation.
Sources
Principales sources consultées : Ollama — téléchargement et fonctionnement local/cloud, Ollama — optimisations MLX sur Apple Silicon, Ollama — modèles vocaux, 24 octobre 2026, Apple Machine Learning Research — inférence locale avec MLX et fiche Amazon.fr du Samsung T7 Shield 1 To.