Faire tourner un modèle de langue chez soi n’est plus une curiosité de laboratoire : Ollama installe un modèle en une commande, et un mini-PC de bureau génère entre 9 et 45 tokens par seconde selon la machine. L’argument n’est pas la puissance brute, c’est la confidentialité de documents qui ne quittent pas le réseau local, la disponibilité sans quota et un coût qui cesse d’être mensuel.
Les limites sont réelles. Dans les configurations abordables présentées ici, il faut surtout viser des modèles compacts ; un modèle de 30 à 32 milliards de paramètres demande beaucoup plus de mémoire disponible. Les TOPS d’un NPU ne prédisent pas à eux seuls la vitesse d’un LLM : le logiciel doit aussi prendre en charge ce NPU. Dans les versions et configurations documentées pour ce comparatif, Ollama et LM Studio s’appuient plutôt sur le CPU ou le GPU. Enfin, « local » ne signifie pas « privé » par construction.
Seize machines vendues en France ont été documentées ; cinq mini-PC sont comparés ici, sans test réalisé par SysKB. Les mesures proviennent de laboratoires tiers et leurs protocoles diffèrent. Le NVIDIA DGX Spark, que nous avons déjà présenté, est ajouté séparément comme référence haut de gamme : son prix et son environnement Linux en font une autre catégorie.
⚡ TL;DR — L’ESSENTIEL EN 30 SECONDES
✅ GMKtec EVO-X2 (3 899,96 €) : pour charger de grands modèles sur une plateforme AMD à mémoire partagée ; 11,4 tokens/s sur un 32B dans la mesure citée.
✅ NucBox K11 (1 189,96 €) : une option évolutive pour débuter avec des modèles 8B ou 14B ; sa RAM remplaçable ne la transforme pas en machine confortable pour un 32B.
✅ Mac mini M6 (939 €) : le choix macOS, silencieux, avec un plafond mémoire définitif à 32 Go.
✅ EVO-T2S (2 199,96 €) : le seul nœud pensé pour tourner 24 h/24, avec 10 GbE.
✅ MS-S1 Max (4 315 €) : un nœud compact extensible pour un homelab ou une baie, après réglage du BIOS. À part : le NVIDIA DGX Spark mérite d’être considéré pour son environnement NVIDIA CUDA et ses 128 Go de mémoire unifiée, mais il est nettement plus cher et ne fait pas partie des cinq machines mesurées.
Le tableau comparatif
Prix relevés le 18 novembre 2026 sur Amazon.fr, TTC, sauf le DGX Spark (boutique officielle NVIDIA France). Les cinq modèles du comparatif sont présentés par profil d’usage, pas classés selon un protocole de test commun.
| # | Modèle | CPU / GPU | Mémoire (RAM / GPU) | Bande passante | 32B dense | Prix |
|---|---|---|---|---|---|---|
| 1 | GMKtec EVO-X2 128 Go / 2 To | Ryzen AI Max+ 395 / Radeon 8060S | 128 Go / 96 Go | ~256 Go/s | 11,4 tok/s | 3 899,96 € |
| 2 | GMKtec NucBox K11 32 Go / 2 To | Ryzen 9 8945HS / Radeon 780M | 32 → 96 Go / ~16 Go | ~89 Go/s | non exécutable | 1 189,96 € |
| 3 | Apple Mac mini M6 16 Go / 256 Go | M6, 12 cœurs / GPU 12 cœurs | 16 Go / ~10,6 Go | 153 Go/s | non exécutable | 939,00 € |
| 4 | GMKtec EVO-T2S 64 Go / 1 To | Core Ultra X7 358H / Arc B390 | 64 Go / ~32 Go | 153 Go/s mesurés | non validé | 2 199,96 € |
| 5 | Minisforum MS-S1 Max 128 Go / 2 To | Ryzen AI Max+ 395 / Radeon 8060S | 128 Go / 96 Go | ~256 Go/s | 5,0 tok/s\* | 4 315,00 € |
| Référence | NVIDIA DGX Spark 128 Go / 4 To | GB10 Grace Blackwell / GPU Blackwell | 128 Go unifiée | 273 Go/s | Non mesuré ici | 7 490 € |
* Réglage d’usine, 2 Go de VRAM : le modèle bascule en partie sur le processeur. Le même APU correctement configuré mesure 11,4 tok/s. Le bruit en charge est détaillé plus bas.
Avant de choisir : trois repères simples
Inférence : faire répondre un modèle déjà entraîné. Ce guide porte principalement sur les LLM de texte ; il ne compare pas les performances en génération d’images, transcription audio ou vision.
8B, 14B, 32B indiquent le nombre approximatif de milliards de paramètres. Un modèle plus grand peut être plus capable, mais il ne sera pas automatiquement meilleur pour chaque tâche. Q4 désigne une quantification qui réduit la taille du modèle en mémoire, avec un compromis possible sur la qualité.
Mémoire unifiée ou partagée veut dire que CPU et GPU utilisent une même réserve physique ; elle n’est pas entièrement disponible au modèle, car le système et les autres applications en prennent aussi une part. Le contexte est la quantité de texte que le modèle peut prendre en compte à la fois : l’augmenter consomme davantage de mémoire.
Tokens/s mesure la vitesse de génération des réponses, pas la vitesse de lecture d’un long prompt ou d’un PDF. Les débits affichés dans cet article sont des repères issus de tests différents ; ils ne prédisent pas exactement votre expérience.
Une option à part : NVIDIA DGX Spark
Le DGX Spark, déjà présenté dans notre dossier consacré au NVIDIA DGX Spark, est pertinent pour un passionné qui veut découvrir la pile IA NVIDIA sous Linux, expérimenter avec de grands modèles ou développer des outils utilisant CUDA. Il réunit 128 Go de mémoire unifiée, une puce GB10 Grace Blackwell et DGX OS, basé sur Ubuntu. NVIDIA annonce jusqu’à 1 PFLOP en FP4 avec sparsité ; ce chiffre de calcul constructeur n’est pas directement comparable aux tokens/s mesurés sur les mini-PC du tableau.
Au relevé du 18 novembre 2026, la boutique officielle NVIDIA France l’affiche à 7 490 € en version 4 To ; vérifiez la configuration et le prix du jour, qui peuvent différer chez les revendeurs. Son système repose sur une architecture Arm : avant achat, vérifiez la compatibilité des outils et dépendances que vous comptez utiliser. C’est une option haut de gamme pour qui veut l’écosystème NVIDIA prêt à l’emploi, pas le premier achat conseillé pour simplement essayer un assistant local.
Pour une première découverte, vous pouvez d’abord essayer un modèle compact sur l’ordinateur que vous possédez déjà avec Ollama ou l’interface graphique de LM Studio. Passez ensuite à une machine dédiée si vous atteignez une limite de mémoire, de vitesse ou de disponibilité. Dans tous les cas, gardez en tête que les fichiers du modèle, le contexte et les applications partagent les ressources de la machine.
1. GMKtec EVO-X2 (128 Go / 2 To) — le choix pour les grands modèles sur APU
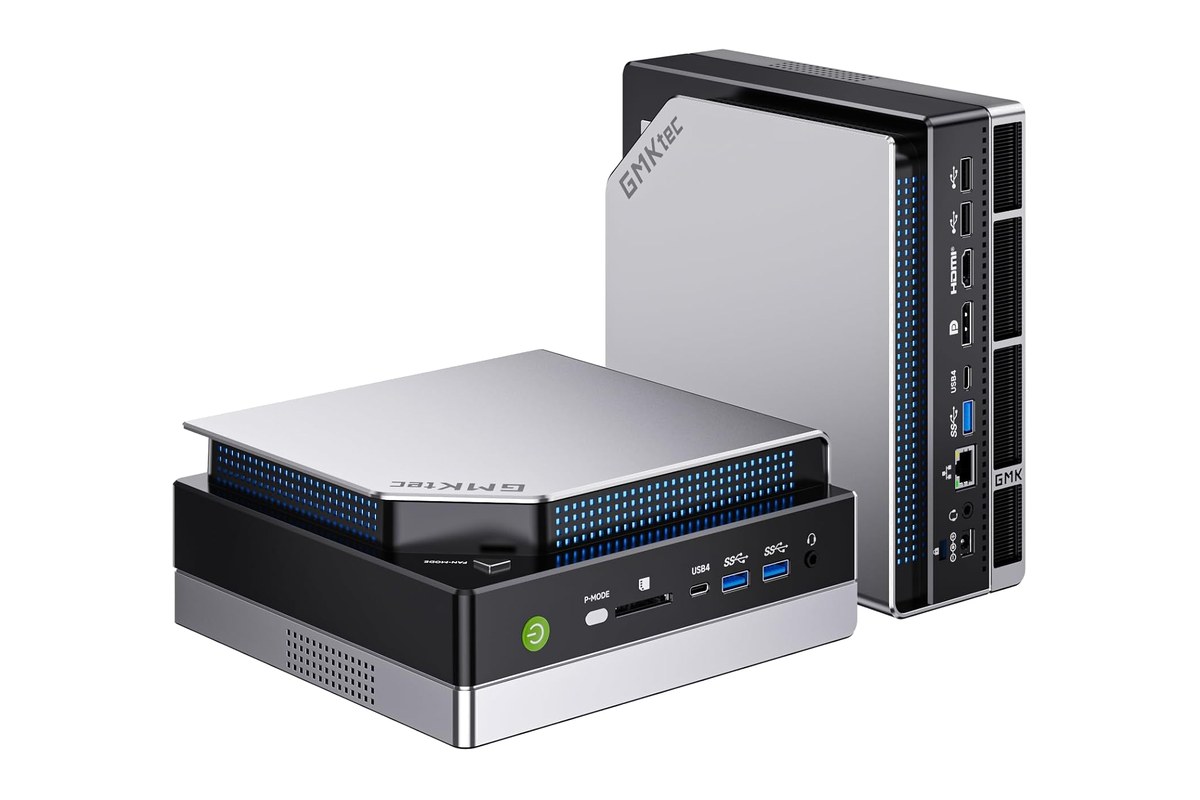
Ryzen AI Max+ 395 (16 cœurs Zen 5, Radeon 8060S à 40 CU), 128 Go de LPDDR5X soudés, dont 96 Go allouables au GPU par le BIOS. 193 × 185 × 77 mm, 1,64 kg, alimentation externe de 230 W.
Ce qu’elle fait tourner. 45,7 tokens/s sur un 7B, 11,4 sur un 32B dense en Vulkan, et 31,4 sur un MoE de 120B (gpt-oss-120b), 55,3 en llama-bench.
Les limites. 47 dB(A) en charge — bureau fermé ou pièce voisine, pas bureau ouvert. Mémoire soudée, donc 128 Go pour la vie de la machine. Un seul 2,5 GbE, ce qui exclut un vrai usage serveur. En contexte très long, restez sur ROCm : sur gpt-oss-120b, Vulkan passe de 44,7 à 4,7 tokens/s à 32K.
Prix. 3 899,96 € (ASIN B0F6X332N6, en stock au 18/11/2026), contre 3 499,99 € sur la boutique du constructeur ; la version 96 Go / 1 To à 2 999,96 € suffit à un 70B en Q8.
En tant que Partenaire Amazon, SysKB réalise un bénéfice sur les achats remplissant les conditions requises, sans surcoût pour le lecteur.
2. GMKtec NucBox K11 (32 Go / 2 To) — le point d’entrée évolutif
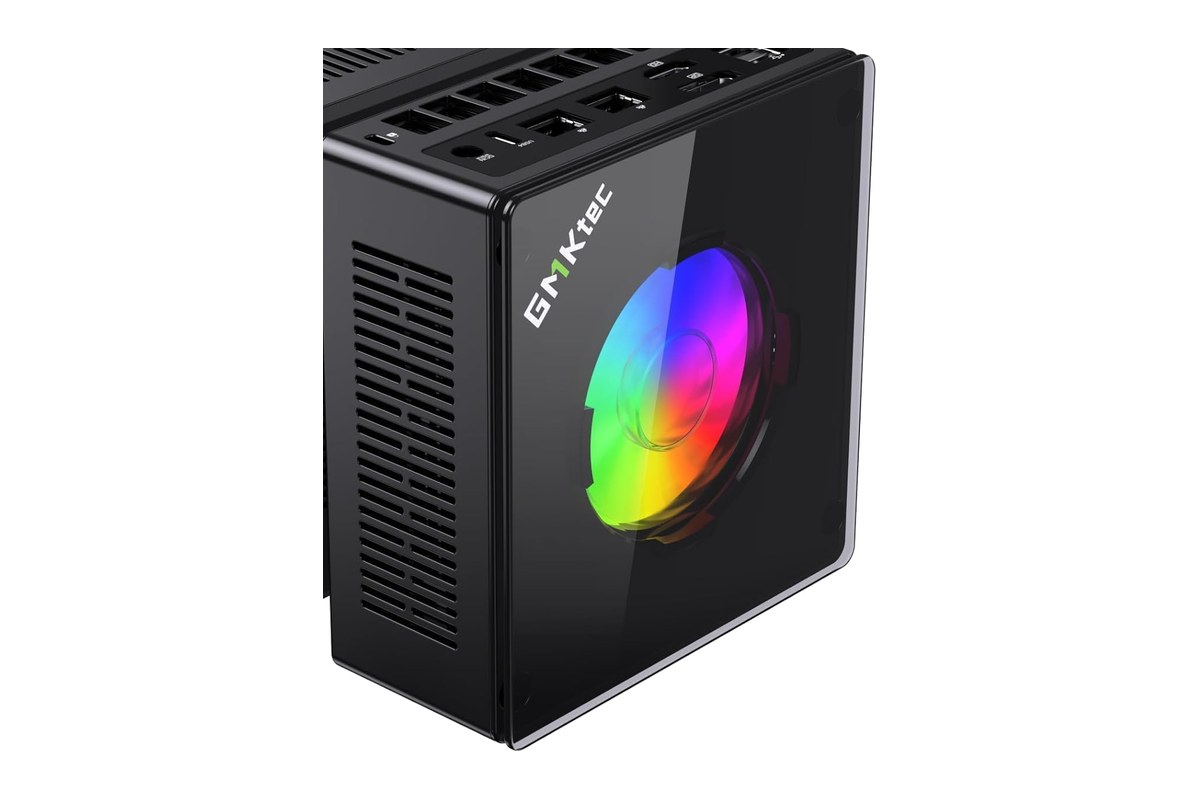
Sous 1 200 €, on ne trouve pas de 32B : ce sont des machines à 8B et 14B. Le K11 est celui dont les performances sur ces deux paliers sont réellement mesurées. Ryzen 9 8945HS, Radeon 780M, 32 Go de DDR5 sur deux slots SO-DIMM — la seule machine du classement dont la mémoire se remplace —, deux 2,5 GbE et un OCuLink pour un GPU externe plus tard.
Ce qu’elle fait tourner. 16 tokens/s sur un 8B et 9 sur un 14B en iGPU sous Ollama, contre 11 et 6 en processeur seul : +50 % en génération, ×3,5 sur le traitement du prompt. Un 32B tombe à 2 tokens/s en CPU.
Les limites. 89 Go/s de bande passante, un tiers d’un Strix Halo : c’est ce qui interdit le 32B, pas le nombre de cœurs. Et le pilote AMD d’origine fait planter la première inférence : la mise à jour Adrenalin est obligatoire, c’est la première cause de retours négatifs.
Prix. 1 189,96 € en 32 Go / 2 To, la configuration liée ci-dessous, vérifiée en stock. La version 32 Go / 1 To existe et se négociait sous 1 050 € au moment de notre relevé, mais nous n’avons pas pu en verrouiller l’ASIN : le bouton pointe donc vers la seule référence dont le lien est vérifié.
3. Apple Mac mini M6 (16 Go / 256 Go) — le meilleur choix pour macOS
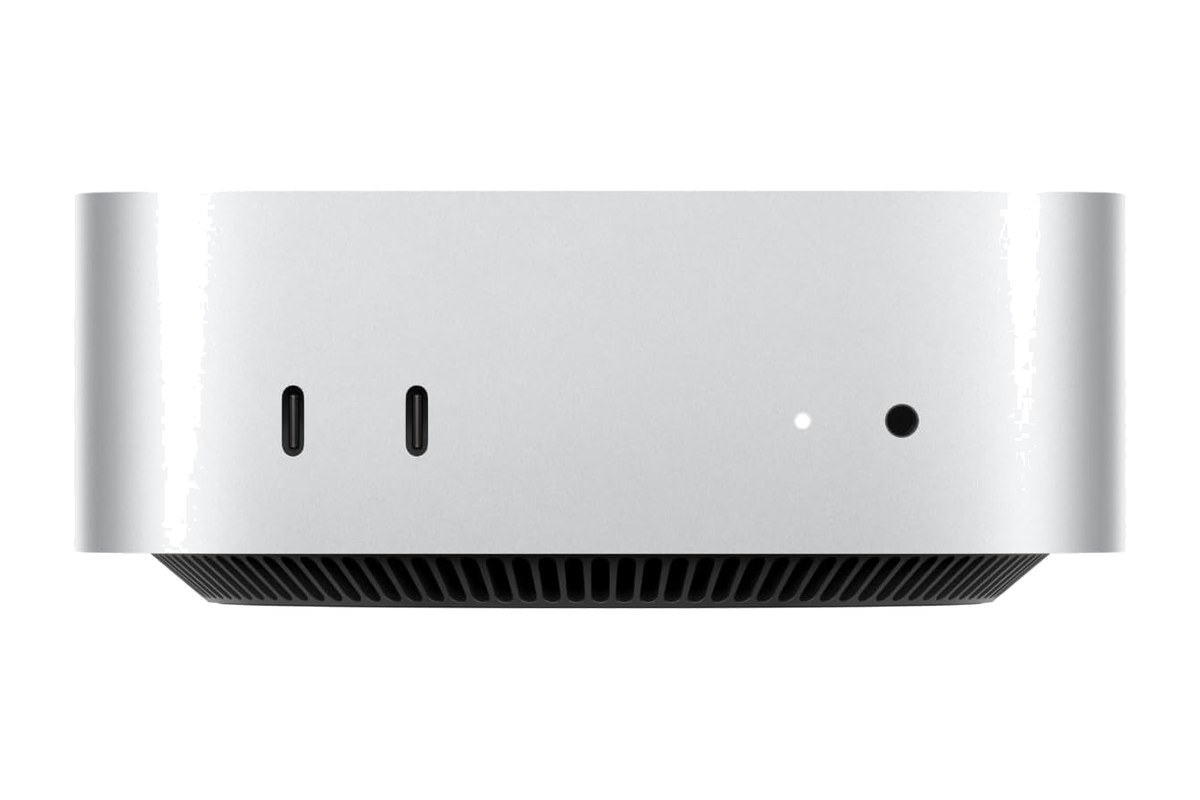
12,7 cm de côté, 0,67 kg, 5 dBA annoncés en veille : le seul appareil du classement qu’on oublie sur un bureau. Puce M6 (12 cœurs CPU, 12 GPU), 16 Go de mémoire unifiée à 153 Go/s, trois Thunderbolt 4, un 2,5 GbE.
Ce qu’elle fait tourner. 33,1 tokens/s sur un 7B, mesuré par Frandroid Lab sur une configuration 24 Go — les 32 Go de mémoire unifiée, elles, bénéficient de 170 Go/s, et c’est cette version-là qui a été mesurée. Sur 16 Go, macOS ne laisse que ~10,6 Go au GPU par défaut, ce qui plafonne à un 8B en Q4 ; pour un 14B (9 Go), il faut relever la limite Metal via iogpu.wired_limit_mb, jusqu’à ~12 Go. Le 32B est hors de portée : 32 Go maximum à la commande.
Les limites. 16 Go est un plancher, pas un confort, et rien n’est évolutif. 256 Go de stockage obligent à un SSD externe dès qu’on garde deux modèles. Bruit en charge et consommation ne sont mesurés par aucune source retenue : nous ne les estimons pas.
Prix. 939,00 € (ASIN B0HGGL1RJ1), contre 1 049 € conseillés par Apple ; la version 24 Go / 512 Go, celle qu’il faut pour un 14B confortable, est à 1 477,04 € (ASIN B0HGG7H7TN) et expédiée sous 1 à 3 mois.
4. GMKtec EVO-T2S (64 Go / 1 To) — l’option réseau pour un homelab
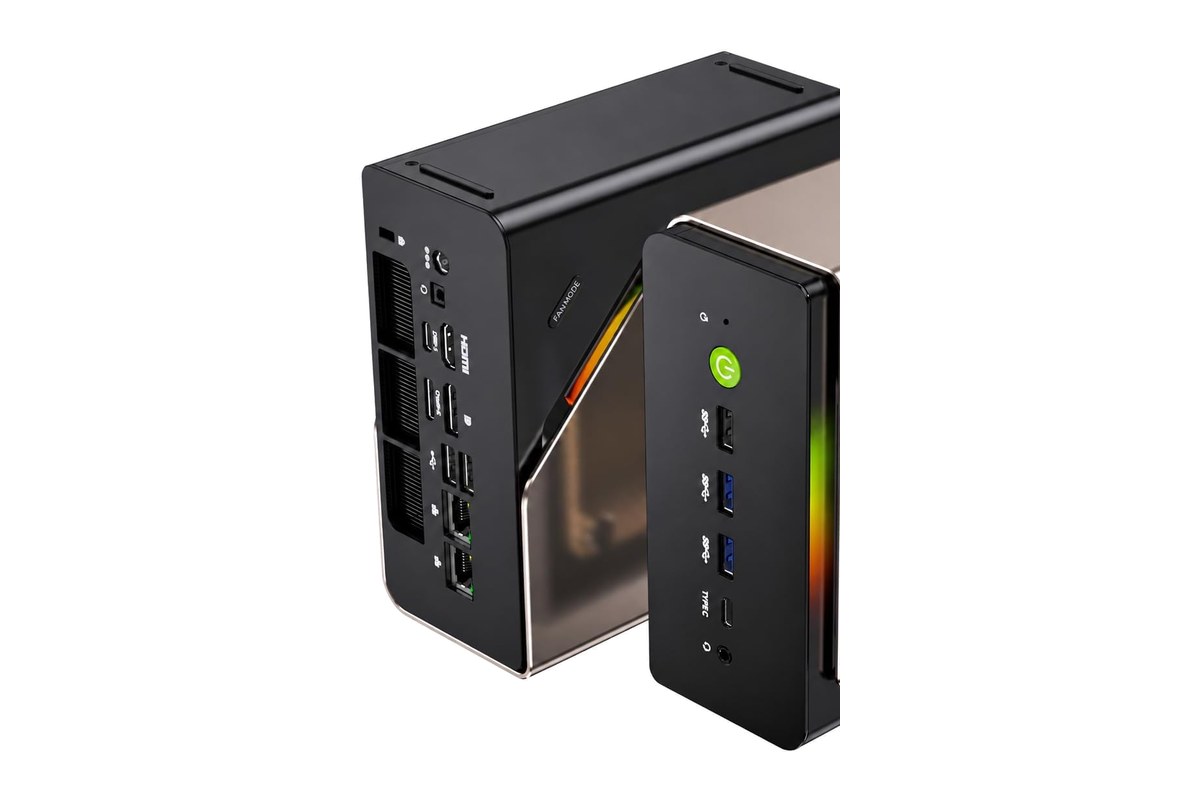
C’est la machine qu’on laisse allumée. Core Ultra X7 358H (16 cœurs, Panther Lake), Arc B390, 64 Go de LPDDR5X soudés, 153 Go/s mesurés, deux M.2 dont un PCIe 5.0, et surtout un 10 GbE plus un 2,5 GbE, unique à ce prix. 1,71 litre, 37 dB(A) en charge, 16,1 W au repos et 70,1 W en pointe.
Ce qu’elle fait tourner. Un 3B à 47,1 tokens/s, et c’est tout ce qui est publié. Sur un 8B, la bande passante autorise une projection de 20 à 25 tokens/s — une estimation physique, pas un résultat. Pour le 32B, le test de référence constate un dépassement de la mémoire GPU : non validé.
Les limites. L’absence de mesure sur 8B et 14B est sa vraie faiblesse documentaire. Ses 16,1 W au repos dépassent de 1,1 W le seuil de 15 W que nous nous étions fixé pour un usage permanent — 35 €/an de veille, assumé. Et 2 199,96 € sur Amazon contre 1 699,99 € sur la boutique GMKtec.
5. Minisforum MS-S1 Max (128 Go / 2 To) — un nœud serveur compact
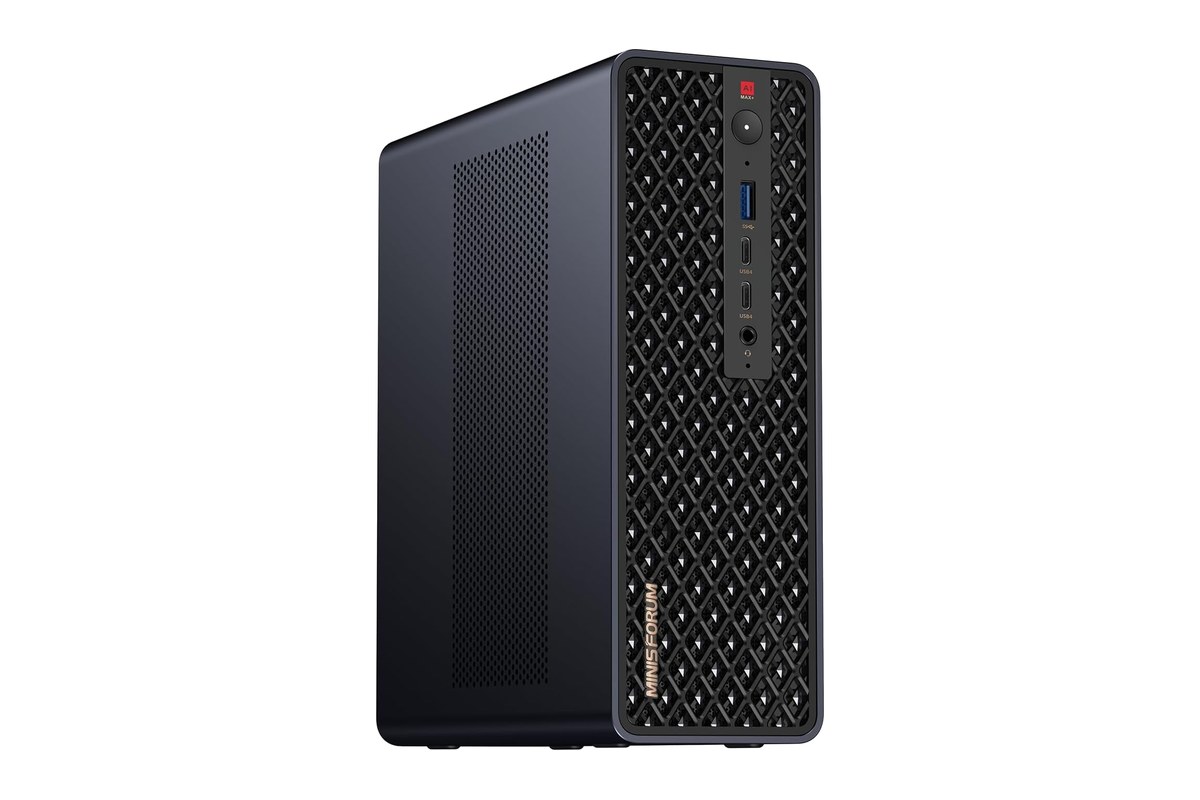
Même APU que le numéro 1, autre métier : là où l’EVO-X2 est une station de travail, le MS-S1 Max est un nœud. 2 × 10 GbE, un slot PCIe 4.0 x4, deux M.2 en RAID, alimentation interne de 320 W, châssis de 3,53 L rackable en 2U. 9 à 12 W au repos, ~120 W en inférence.
Le piège à connaître. Les chiffres publiés — 32B à 5,0 tokens/s, 7B à 22,5, 70B à 2,38 — sont obtenus avec le réglage d’usine qui laisse 2 Go au GPU ; le modèle bascule en partie sur le processeur. Le même APU configuré sur l’EVO-X2 mesure 11,4 tokens/s : un facteur 2,3. Passez le carveout à 64–96 Go avant toute mesure.
Les limites. Plus de 43 dB(A) en mode Performance et une ventilation qui ne s’arrête jamais : local technique ou baie, pas un salon. Mémoire soudée, pas d’OCuLink, SSD QLC. Et le « cluster de deux nœuds à 10,87 tokens/s sur un 235B » est un chiffre vendeur non vérifié.
Prix. 4 315,00 € (ASIN B0HCNRF4Y1) ; la version 64 Go / 2 To à 2 799,00 € couvre un 70B en Q4 pour 1 500 € de moins, mais sa mémoire GPU allouable n’est pas documentée.
Guide d’achat : les six points qui décident vraiment
Mémoire : la taille exploitable, pas la taille installée
À titre indicatif, les poids seuls d’un modèle Q4 peuvent occuper environ 5,2 Go pour un 8B, 9 Go pour un 14B, 19 Go pour un 32B et 40 Go pour un 70B ; le fichier exact varie selon le modèle et sa quantification. Il faut encore réserver de la mémoire au contexte, au système et aux autres applications. Pour un modèle MoE, la taille totale des poids chargés n’est pas la même chose que le nombre de paramètres activés pour chaque token. Vérifiez la mémoire disponible avec le moteur choisi ; une partie de la RAM peut être réservée au GPU dans le BIOS ou par le système, sans devenir de la VRAM dédiée.
Bande passante : le vrai plafond de vitesse
Lors de la génération, la bande passante mémoire limite souvent le débit, mais sa division par la taille des poids ne fournit qu’un ordre de grandeur théorique. Le résultat réel dépend aussi du moteur, du GPU, de la quantification, du contexte et du réglage mémoire. Les valeurs de 45 tokens/s sur un 7B et 11 sur un 32B dense sont ici des résultats mesurés sur la configuration et le logiciel cités, pas une promesse pour tout appareil partageant une bande passante proche.
Mac mini ou mini-PC Windows/Linux : deux philosophies, pas deux vitesses
Le Mac mini joue la sobriété : mémoire unifiée gérée par le système, Metal stable, 5 dBA annoncés en veille, rien à régler. En face, un mini-PC Windows ou Linux ouvre le BIOS, le carveout GPU, les pilotes AMD ou Intel et, parfois, la mémoire remplaçable — le K11 accepte 96 Go de DDR5, ce qui n’existe pas chez Apple.
Le plafond est le vrai clivage. Apple s’arrête à 32 Go et à un GPU de 12 cœurs : un 32B dense y est impossible, quel que soit le budget. À l’inverse, un Strix Halo à 96 Go de mémoire GPU fait tourner ce même 32B, mais il coûte quatre fois plus cher et se fait entendre. Entre les deux, les machines à 32 Go de DDR5 ne changent pas de catégorie : elles font très bien du 8B et du 14B, pas davantage.
Restent les à-côtés, souvent décisifs dans un homelab : 10 GbE, deux M.2, un OCuLink ou un slot PCIe n’existent pratiquement pas dans l’écosystème Mac. Si la machine doit servir un NAS et plusieurs postes, c’est un mini-PC. Si elle doit rester silencieuse sur un bureau et servir un seul utilisateur, le Mac mini reste le meilleur rapport simplicité/consommation. La question rejoint celle des PC Windows conçus pour l’IA locale, où Microsoft impose d’ailleurs 64 Go de mémoire unifiée et 250 Go/s comme plancher : notre dossier sur Project Zenith détaille ce que cela implique.
GPU, OS et runtimes : plusieurs chemins possibles
Dans les cinq mini-PC du comparatif, CUDA n’est pas disponible ; le DGX Spark est l’exception, avec son environnement NVIDIA sous Linux. Metal accélère les modèles compatibles sur Apple Silicon ; ROCm et Vulkan peuvent accélérer certains GPU AMD, avec des résultats variables selon le matériel, les pilotes, le logiciel et le contexte. Ollama est un moyen simple de démarrer, LM Studio propose une interface graphique et des réglages d’accélération, et llama.cpp est souvent utilisé pour les mesures. Vérifiez la prise en charge du NPU pour la version précise du logiciel et du matériel : le chiffre de TOPS seul ne garantit pas qu’un modèle l’utilisera. Sur Windows, macOS ou Linux, l’installation et le niveau de réglage diffèrent. Pour la suite, notre guide Ollama sur Mac et le RAG sur ses PDF avec Ollama et Open WebUI donnent les bases.
Consommation et bruit : deux arbitrages, pas un argument de vente
À 0,25 €/kWh, une machine allumée 24 h/24 avec deux heures d’inférence quotidienne coûte entre 41 € (K11) et 55 € (EVO-X2) par an : cela départage deux machines d’une même classe, pas un arbitrage à 3 000 €. Le bruit compte davantage : 34,6 dB(A) pour le K11, 37 pour l’EVO-T2S, 47 pour l’EVO-X2, plus de 43 en permanence pour le MS-S1 Max.
Mini-PC ou NAS ? Les deux, avec des rôles séparés
Un NAS stocke et sauvegarde, il n’infère pas. L’architecture qui fonctionne sépare les rôles — NAS pour les documents, mini-PC pour l’inférence, 10 GbE entre les deux, API locale exposée aux autres appareils. Les NAS à NPU, comme l’UGREEN iDX6011 Pro ou ceux dotés de DSM 7.4, ajoutent de l’indexation, pas la puissance d’un 32B. Pour une machine dédiée aux agents, le ASUS ProArt GR1X est l’autre approche, et notre guide pour isoler ses objets connectés s’applique à un nœud permanent.
Questions fréquentes
Faut-il forcément Ollama pour faire tourner une IA locale ?
Non. Ollama est le plus simple à démarrer et gère le téléchargement des modèles ; LM Studio ajoute une interface graphique et un réglage fin de l’offload GPU ; llama.cpp reste la référence pour mesurer. Les trois lisent les mêmes fichiers GGUF.
Un mini-PC à 32 Go de RAM peut-il faire tourner un modèle de 30B ?
Pas confortablement. Un 30–32B en Q4 pèse 19 Go, plus le cache de contexte : il faut au moins 24 Go réellement allouables au GPU. Sur un K11, le modèle bascule en partie sur le processeur et tombe à 2 tokens/s ; sur un Mac mini plafonné à 32 Go, il reste hors de portée.
7B, 13B ou 30B : quel palier pour quel usage ?
Un 7–8B suffit pour de la reformulation, du résumé et de l’assistance quotidienne, à 16–45 tokens/s selon la machine. Un 14B apporte un vrai gain en rédaction et en analyse documentaire, à 9 tokens/s sur une machine d’entrée de gamme. Un 30–32B dense change la qualité sur le raisonnement et le code, mais exige 128 Go de mémoire unifiée et ne dépasse pas 11 tokens/s.
Quel budget minimum pour une IA locale réellement utilisable ?
Autour de 1 000 € pour un assistant 8B ou 14B. En dessous, les machines à processeur N100/N150 vendues comme « PC IA » n’ont ni la mémoire ni la bande passante nécessaires.
L’IA locale garantit-elle la confidentialité ?
Non. Le modèle ne sort pas de la machine, mais l’application qui l’entoure peut envoyer des données, une API locale mal protégée est accessible depuis le réseau et les clients de bureau embarquent leur propre télémétrie. Confidentialité veut dire : modèle local, application auditée, réseau segmenté, télémétrie coupée, aucun accès sortant non maîtrisé.
Conclusion : quelle machine pour quel profil ?
Moins de 1 200 € : le Mac mini M6 à 939 € sous macOS, le NucBox K11 à 1 189,96 € sinon. Les deux font tourner un 8B et un 14B, aucun un 32B.
Autour de 2 000 €, un agent permanent : le GMKtec EVO-T2S — deux liens réseau, 37 dB, 16 W au repos, 64 Go. C’est la machine d’un homelab.
Autour de 4 000 €, un vrai 32B dense : le GMKtec EVO-X2. 128 Go unifiés, 96 Go au GPU, 11,4 tokens/s sur un 32B et 31 sur un MoE de 120B. Prévoyez un casque.
Plus haut, un nœud serveur : le Minisforum MS-S1 Max, pour ses 2 × 10 GbE, son slot PCIe et son format 2U — après réglage du BIOS.
Un dernier mot : aucune de ces machines n’a été testée par SysKB, et seules les mesures du tableau Frandroid EVO-X2 / EVO-X3 / MS-S1 Max, réalisées le même jour, sont strictement comparables. Le reste est une lecture documentée. Pour un premier test, transcrire de l’audio en local avec Whisper révèle vite si la machine suit.
Sources
- Frandroid — tests du GMKtec EVO-X3, de l’EVO-T2S, du NucBox K11 et du Minisforum MS-03, 2026.
- ServeTheHome — GMKtec EVO-X2, Minisforum MS-S1 Max.
- NotebookCheck — EVO-X2, MS-S1 Max.
- Fiches constructeur : Apple Mac mini, GMKtec, Minisforum MS-S1 Max, AMD Ryzen AI Max+ 395.
- Prix et disponibilité : fiches Amazon.fr ASIN B0F6X332N6, B0F2Y8BQV8, B0HGGL1RJ1, B0H1R41XY8 et B0HCNRF4Y1, relevées le 18/11/2026.
Prix indicatifs, relevés le 18 novembre 2026 sur Amazon.fr, susceptibles d’évoluer. Les liens Amazon de cet article sont affiliés.